Appearance
Stable Diffusion 使用教程:2026 本地 WebUI 入门与参数指南
Midjourney 适合追求画面质感、愿意订阅网页服务的创作者;如果你更在意可本地运行、可换模型、可批量出图、数据不出本机,那 Stable Diffusion 往往是更好的选择。这篇 Stable Diffusion 使用教程面向新手:讲清它是什么、和 Midjourney 怎么选、本地 WebUI 怎么装、文生图与常用参数怎么调,以及模型与 LoRA 的基本用法——全程聚焦工具本身,不捆绑第三方代理产品。
Stable Diffusion 是什么
Stable Diffusion(常简称 SD)是开源的文生图扩散模型体系。和闭源网页工具不同,你可以:
- 在自己的电脑(或云主机)上运行推理;
- 更换不同的基础模型(Checkpoint)与风格插件(LoRA);
- 用 ControlNet 等扩展精确控制姿势、构图、线稿;
- 把工作流固化成可重复的参数组合,适合批量生产。
常见使用入口有两类:
- 图形界面:AUTOMATIC1111 WebUI、ComfyUI、Forge 等,适合大多数创作者;
- 工作流节点:ComfyUI 以节点连线著称,灵活但学习曲线更陡。
本文以目前仍广泛使用的 WebUI 文生图流程为主线,帮你先跑通“提示词 → 出图 → 调参”,再决定要不要深入 ComfyUI。
和 Midjourney 怎么选
| 维度 | Stable Diffusion | Midjourney |
|---|---|---|
| 部署方式 | 本地或自建服务 | 官方网页订阅 |
| 模型自由度 | 极高,可换 Checkpoint/LoRA | 官方模型为主 |
| 画面“开箱即美” | 依赖模型与调参 | 通常更省心 |
| 学习成本 | 中高 | 中低 |
| 隐私与离线 | 可完全本地 | 云端生成 |
| 适合人群 | 想控细节、批量、定制风格 | 想快速出高质量概念图 |
不是互斥关系:概念探索可用 Midjourney,量产与私有素材管线更适合 SD。Midjourney 操作见 Midjourney 使用教程。
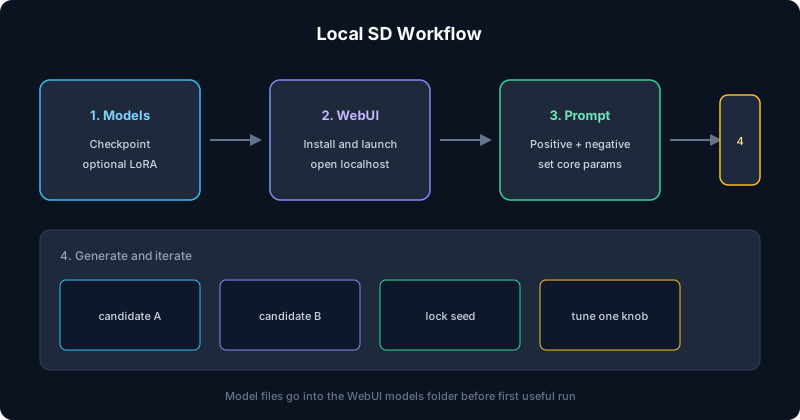
本地工作流可以概括为:准备模型文件 → 启动 WebUI → 输入提示词与参数 → 生成并迭代。
硬件与环境要求(务实版)
本地跑 SD,显卡是关键瓶颈:
- NVIDIA 显卡 + 足够显存体验最好(常见建议从 6GB/8GB 起能跑基础分辨率,12GB 以上更从容);
- 只有集显或显存很小也可以尝试,但要降低分辨率、启用优化选项,速度与效果都会受限;
- 内存建议 16GB 及以上;磁盘预留充足空间(单个模型动辄 2GB~7GB)。
软件侧通常需要:
- 较新的 Python 环境(以你所选 WebUI 文档要求为准);
- Git(用于克隆项目);
- 对应平台的 GPU 驱动。
如果你暂时没有合适显卡,也可以先用支持 SD 的在线平台练手参数与提示词,再迁回本地——但模型版权与平台条款要各自遵守。
安装 WebUI 的大致步骤
不同系统细节不同,但逻辑一致:
- 安装 Git 与符合要求的 Python;
- 克隆你选择的 WebUI 仓库(例如 AUTOMATIC1111 的 stable-diffusion-webui);
- 首次运行安装脚本,让它拉取依赖;
- 把下载好的 Checkpoint 模型放到
models/Stable-diffusion目录; - 启动后浏览器打开本地地址(常见为
http://127.0.0.1:7860)。
安装过程最常见的问题是:依赖下载失败、CUDA/驱动不匹配、路径含特殊字符。遇到报错时,优先对照该 WebUI 当前文档的环境说明,而不是盲目换教程版本——SD 生态迭代快,旧教程参数可能已失效。
文生图:从第一张图开始
进入 txt2img(文生图)页后,最小可用流程是:
- 在顶部选择一个 Checkpoint 模型;
- 在正向提示词(Prompt)写画面描述;
- 在反向提示词(Negative prompt)写不想出现的元素;
- 设定尺寸、步数、采样器、CFG,点击生成。
示例(可按需改写):
正向:
a red fox sitting on a mossy stone in a misty forest,
soft morning light, highly detailed fur, cinematic composition

反向:
lowres, blurry, deformed, extra limbs, watermark, tex中文提示词很多模型也能理解,但大量社区模型与质量词仍以英文标签训练为主;实务上常见做法是:主体可用中文思考,关键质量词与风格词用英文,或先用翻译整理一版英文提示词再生成。
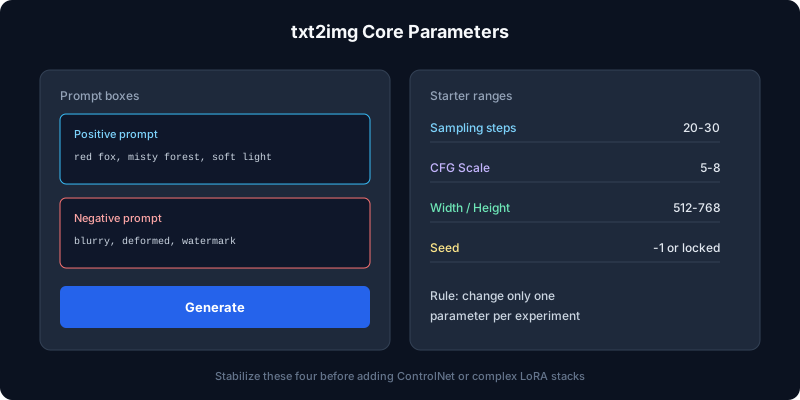
新手优先掌握四个旋钮:分辨率、Sampling steps、CFG Scale、Seed;先稳住这四个,再谈高级扩展。
新手最该懂的参数
| 参数 | 作用 | 新手建议 |
|---|---|---|
| 分辨率 Width/Height | 出图尺寸 | 先从 512~768 一边长试起,显存不够就降 |
| Sampling steps | 去噪迭代次数 | 常见 20~30;太低糊,太高收益递减 |
| CFG Scale | 提示词遵从强度 | 常见 5~8;过高易僵硬、过饱和 |
| Sampler | 采样算法 | 先固定一个常用采样器做对比,勿同时改太多变量 |
| Seed | 随机种子 | -1 为随机;出了好图就锁定 Seed 做微调 |
| Batch | 一次出几张 | 显存允许时可一次出 2~4 张做挑选 |
调参原则:一次只改一个变量。否则你不知道是提示词生效了,还是 CFG 改坏了。
模型、LoRA 与扩展(先建立正确心智)
- Checkpoint(大模型):决定“底子”——像写实、动漫、建筑等大方向;
- LoRA:轻量风格/角色插件,叠在大模型上,适合补特定画风或角色特征;
- VAE:影响色彩与细节解码,某些模型需要搭配指定 VAE;
- ControlNet(进阶):用线稿、深度图、姿态骨架控制构图,是 SD 相对网页工具的重要优势。
下载模型时务必注意来源与许可协议:是否允许商用、是否要求署名、是否禁止再分发。不要默认“能下载就能商用”。
提示词怎么写才更稳
SD 提示词可以比聊天模型更“标签化”,但仍建议保持结构:
- 主体(谁/什么);
- 动作与场景;
- 光影与镜头;
- 画质词(适度,堆太多反而互相打架);
- 反向提示词清掉常见瑕疵。
若你已经学过通用提示词方法,可以把“约束清晰、少空话”迁移过来,再叠上 SD 的质量词与反向词习惯。方法见 提示词工程教程。
Stable Diffusion 使用教程常见问题(FAQ)
Q:Stable Diffusion 必须付费吗? A:模型与多数 WebUI 本身开源可本地使用;你需要承担的是电脑硬件与电费,或云主机费用。第三方在线平台另算。
Q:没有高端显卡能学吗? A:能先学提示词、参数与工作流概念;本地出图会慢或受限。也可先用在线 SD 服务验证流程,再决定是否升级硬件。
Q:出图总是手脚崩坏、人脸崩坏怎么办? A:先换更匹配你题材的模型;降低分辨率试跑;加强反向提示词;进阶再用修复(inpaint)或专用修复模型。不要只靠无限加质量词硬堆。
Q:WebUI 和 ComfyUI 我该选哪个? A:想尽快出第一张图,选 WebUI 更直接;需要复杂可复现工作流、节点化管线,再学 ComfyUI。可以先 WebUI 建立直觉,再迁移。
Q:生成的图片能商用吗? A:取决于你使用的 Checkpoint/LoRA 的许可证,以及你所在地区的法律规定。开源不等于一律可商用,发布前请核对模型页面的 License。
总结
Stable Diffusion 的核心价值是可控与可扩展:模型可换、流程可本地、细节可用 ControlNet 锁定。新手不必一次学完所有扩展——先装好 WebUI,跑通文生图,吃透分辨率、步数、CFG、Seed 四个参数,再按需加 LoRA 与 ControlNet。若你更想要“少调参、快速出漂亮概念图”,可以并行参考 Midjourney 使用教程;若卡在提示词结构,先补 提示词工程教程。
相关资源
- Stable Diffusion 与各 WebUI 的官方/社区文档(以你实际选用的项目 README 为准)
- 本站 AI工具教程 分类
- 延伸阅读:Midjourney 使用教程、提示词工程教程
本文基于公开的通用使用方法整理;具体安装命令、界面按钮名称与默认参数会随 WebUI/模型版本变化,请以你所选项目的当前文档为准。请合法使用模型与生成内容。