Appearance
把 PDF 丢给 AI 问问题:五次翻车记录与改法
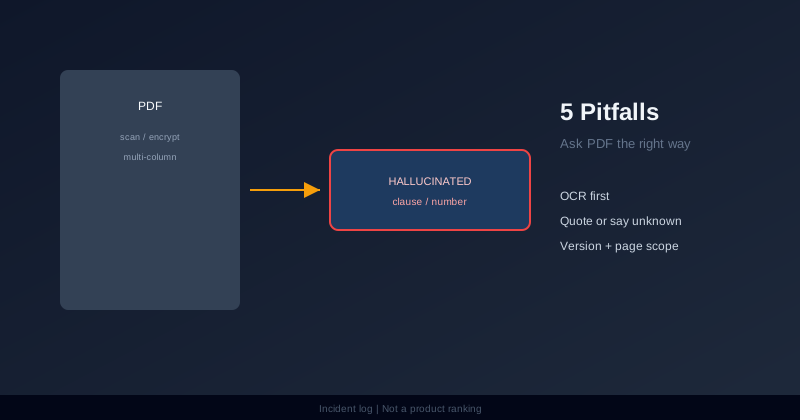
我习惯把 PDF 当黑盒:上传,提问,等答案。第一次觉得不对劲,是在一份二十页的采购合同上——模型用非常肯定的语气写了一段「违约金为合同总额 30%」。我把 PDF 搜了一遍,没有这句话。页码、章节号都对,唯独条款是编出来的。
那次之后,我不再问「哪个 AI 读 PDF 最强」,而是记「我在什么条件下问,才会把自己坑了」。下面五次翻车按时间顺序写,每次结构一样:我怎么问的 → 出了什么事 → 后来怎么改。不贴产品排行榜;同一套问法,换 ChatGPT、Claude 或带文档功能的网页工具,该踩的坑仍会踩一部分。
下文里的「模型」有时指网页上传,有时指粘贴段落——翻车多半发生在「我以为它全读了」,而不是发生在某个品牌 logo 上。
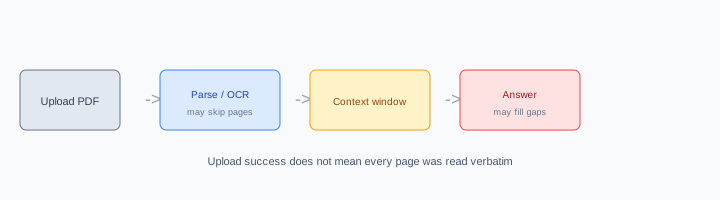
翻车一:扫描件 PDF,问「第三条约定了什么」
我怎么问的
把供应商发来的扫描合同(图片型 PDF)整份上传,问:请总结第三条的主要义务。
出了什么事
回答读起来像那么回事:交货时间、验收标准、付款节点都有。我对照纸质盖章版才发现,第三条是争议解决地,交货条款在第五条。模型把后文常见模板「拼」进了第三条的名下。
原因(事后才明白)
扫描件如果没有先 OCR,很多系统只能「看图猜字」或只处理部分页。第三条若在扫描里模糊,模型会用语料里常见的「合同第三条」套路填空。
现在怎么问
- 先用 OCR(Adobe、本地工具或云 OCR)导出可搜索 PDF,或把相关页复制成文字贴进对话。
- 问题里写死边界:
仅根据我粘贴的以下文字回答,找不到就写「原文未提及」: - 要它引用原句再解释,不要只要摘要。
额外一条:扫描件如果倾斜、带公章阴影,OCR 会把「8」认成「3」。我现在的习惯是 OCR 后随机抽三行人工对照,再交给 AI。多五分钟,少一次签错字。
翻车二:百页论文,问「作者的结论是什么」
我怎么问的
上传整篇 PDF,问:这篇论文的主要结论和对行业的启示是什么?
出了什么事
得到一段流畅的中文,还分了「理论贡献」「实践建议」。导师问:Figure 4 对应的实验你看了吗?——Figure 4 里的数字和 AI 写的不一致。结论部分大方向没错,细节张冠李戴。
原因
长 PDF 往往受上下文长度限制,模型可能只稳定「看到」前言、摘要、结论段,中间实验节被压缩或没进上下文。它会把摘要里的结论扩写,补上「听起来合理」的行业启示。
现在怎么问
- 不要一次问整篇。先问:
列出本文各节标题及页码范围(若工具支持页码),再只上传结论节 + 方法节。 - 问具体:
根据第 X 节,作者对假设 H1 的统计结论是什么?请引用原文句子。 - 数字、样本量、p 值 —— 一律要求对照原文复述,不允许估算。
写课程论文的人还可以再狠一点:让 AI 先只列「文中有哪些图、表、编号各是什么」,你人工核对一遍编号是否存在,再允许它解释 Figure 4。这一步很笨,但能挡掉一半张冠李戴。
翻车三:双栏排版 + 页眉页脚,问「附件清单有哪些」
我怎么问的
公司制度 PDF,双栏、每页有「内部资料·请勿外传」。问:附件清单里列了哪些表单?
出了什么事
清单里多出了两个听起来很正式的表单名,实际上来自页眉重复出现的短语和某一栏脚注里的示例文字,并不是附件列表。
原因
模型不区分「版式噪声」和「正文结构」。页眉在每页重复,权重被抬高;双栏导致阅读顺序错乱,列表项被拆碎。
现在怎么问
- 上传前用 PDF 阅读器「复制文本」,肉眼看顺序是否错乱;乱则只复制附件章节。
- 提示里加:
忽略页眉、页脚、水印文字;只统计标题为「附件」或「附录」下的编号列表。 - 让它输出 表格:附件编号 | 原文名称 | 所在页码,页码对不上就判失败。
政府公开文件、国标 PDF 常有横竖混排和嵌入字体。复制出来的文字顺序像洗牌。这类文件我基本放弃整份上传,改用官网 HTML 版或纯文本公报;PDF 只当打印件存档。
翻车四:密码保护的 PDF,问「总额是多少」
我怎么问的
财务发来的加密 PDF,我本地能开,直接上传平台。问:Q3 合计金额是多少?
出了什么事
平台提示上传成功,回答给了一个精确到分的数字。我和 Excel 核账,差四位数。再试一次,数字又变了。
原因
加密 PDF 在部分管道里只能读到文件名或空白层,模型在没有真实表格数据时仍会「补全」一个 plausible 的数字。这是最危险的一类:看起来精确,其实是幻觉。
现在怎么问
- 解密后只复制相关表格为 CSV 或纯文本粘贴;或导出单页为图片 + 说明「以图中表格为准」。
- 问题改为:
以下数据中,Q3 合计单元格的值是多少?若无法从下列文字确定,回答「无法从提供内容确定」。 - 永远和源文件人工交叉验证金额,AI 不做最终记账。
表格型 PDF 还有一类坑:合并单元格。复制到对话框里,行和列的关系会丢。财务问「这一行合计」时,我会截图表格区域,并说明「以图片中单元格为准,文字粘贴仅作辅助」。只粘贴文字往往不够。
翻车五:多文件版本,问「最新版里删了哪条」
我怎么问的
文件夹里有两个类似文件:policy_v2.pdf 和 policy_v3.pdf,我随手上传了 v2,问:相比上一版,删除了哪些条款?
出了什么事
回答列了三条「删除项」,像模像样。同事指出 v2 相对 v1 的变更才对,而我问的是 v3 相对 v2——文件版本错了,整个 diff 无意义。
原因
模型不知道你本地的版本命名习惯,也不会自动去抓 v3。它会在单文件内做「臆想 diff」,或用训练记忆里的「政策通常删什么」来凑。
现在怎么问
- 文件名写进提示:
以下为 policy_v3.pdf 的全文;请仅与我在下一条消息提供的 policy_v2 全文对比。 - 分两次粘贴两个版本的相关章节,或用一个支持多文档同会话的工具,并明确
@文件角色。 - 让它输出:
仅在 A 出现 / 仅在 B 出现 / 共有但措辞不同三类,每条带原文短引。
版本混乱在协作里更常见:钉钉/飞书导出的 PDF 文件名带时间戳,本地又有人另存为「最终版」「最终版2」。我现在强制团队约定:文件名必须带 v 号,问 AI 之前先 human 确认打开的是哪一版。AI 不会替你修文件管理。
手机上传 vs 电脑:我少用手机问 PDF
手机上上传 PDF 图省事,在地铁里问一句「这合同能签吗」很诱人。我踩过一次:手机端压缩、分页预览不完整,长合同只处理了前半。回答语气还一样肯定。
现在硬规则:涉及签字、金额、期限的 PDF,只在电脑端处理,且必须能看见页码条。探索性阅读(「这篇白皮书讲啥行业」)才用手机。
五次下来,我固定的「提问套话」
我现在会在 PDF 问题前粘下面这段(按需删行),像给合作者写 brief:
你是一名文档分析助手,不是作者。
规则:
1. 仅根据我提供的文本/页面回答;找不到写「原文未提及」,不要推测。
2. 涉及数字、日期、比例、法律后果,必须引用原文短句并标注页码(若已知)。
3. 忽略页眉、页脚、水印、重复页眉。
4. 若问题超出提供文本范围,直接说明范围不足,不要补常识。
我的问题:套话不能消灭幻觉,但能把胡编的压力降下来,也方便你一眼看出它是在引用还是在发挥。
和「专门读 PDF 的工具」怎么配合
NotebookLM、各类 ChatPDF、企业知识库,本质都是:检索 + 生成。差别在于索引是否真建立在全文、能否返回段落定位。我的用法是:
- 探索性阅读(这篇讲什么、结构怎样)→ 可以用上传整份,但要接受摘要级误差。
- 决策性阅读(签不签字、报不报账、引用写进论文)→ 必须段落级引用 + 人工核对。
- 重复问同一份制度 → 值得建一次索引(NotebookLM 或内部 RAG),比每次重新上传省时间,但仍要抽查几段原文。
没有银弹。有的是「问题粒度越细、原文贴得越准,翻车越少」。
和 NotebookLM 使用教程 里强调的「基于文档回答」是同一逻辑:索引质量决定上限。差别在于 NotebookLM 更适合同一资料库反复问;临时的一次性合同,我更愿意复制段落 + 严格套话,而不是先花半小时建库。
如果你只记三句话
- 上传成功 ≠ 模型读全了,扫描件和加密件尤其可疑。
- 越像「结论 / 金额 / 违约金」这种硬信息,越要原文引用,否则默认当没说过。
- 版本、页码、附件边界写进问题里,比换第五个 AI 产品管用。
我仍会拿 PDF 问 AI,只是不再把回答当「读过一遍」的替身。它更像一个需要盯着的实习生:快,但不能代签。
如果你也有被 AI「编条款」或「编数字」的经历,不妨记一条:当时问的是整份还是节选、有没有要求引用。一条记录,下次就能少踩一次。
后记:为什么我不做「最佳 PDF AI 排行榜」
市面上一大堆榜单会比较上传页数上限、是否支持 OCR、价格。那些数字会变,而且同一上限下,扫描件和原生电子版 PDF 完全是两种生物。我更相信按翻车类型记住约束条件,而不是按 logo 选赢家。
若你手头只有免费对话额度,优先级可以是:先 OCR → 再节选粘贴 → 再加套话 → 最后才问「总结全文」。顺序反了,就会得到流畅但危险的答案。
和人工律师、会计的分工(一句说清)
AI 适合:缩小阅读范围、列问题清单、对比两个版本的文字差异。 AI 不适合:替你做是否签约、是否入账的最终判断。 我现在的习惯是:AI 出「待核实清单」,人逐项勾 PDF 原件。清单有时很长,但比签错字便宜。
可复制:问之前自检四行
[ ] 这是扫描件吗?需要 OCR 吗?
[ ] 我问的是硬信息(金额/期限/责任)还是软理解(大意/背景)?
[ ] 文件版本唯一吗?文件名写进提示了吗?
[ ] 我是否要求「找不到就说未提及」并引用原句?
四行打勾再发送,不能杜绝幻觉,但能避免「问法本身就在邀请它编」。
一次成功的对照(让文章不只写失败)
同一采购合同,OCR 后我只贴了「第五条 + 第八条」,并用了上文套话。问:「卖方延迟交货超过 15 个工作日,买方有哪些权利?请只引用粘贴文本。」
这次回答里每条权利后面都带了原文短引,其中一条写「原文未提及自动解约,仅提及按日计违约金」。我去 PDF 里核对,确实如此——没有编 30% 那种吓人的比例。成功不是因为换了更贵的会员,而是因为问题范围变窄、且允许它说不知道。
我把这次对话链接存进笔记,标题叫「合同类 PDF 标准问法」。下次不必从零摸索。你也可以为自己常问的那类文件(制度、论文、发票)各存一条「标准问法」,比收藏十个 ChatPDF 链接更管用。PDF 不会因为你换了更贵的 AI 就变得更好读;好读的,永远是你肯花时间核对的那几页原文。翻车记录写到此为止;下次若再被编条款,我会把第六次补在同一页笔记的最底下,当作给自己的提醒,而不是新的教程。