Appearance
要不要自己训 LoRA:一张如果…就…旁注树
一刷到好看的角色图,就有人问:要不要自己训个 LoRA?这句话听起来进取,账单却常写在显存、时间和一堆废权重上。这篇不教训练参数,只在分岔口做旁注:什么情况下该训,什么情况下不该。出图与工作流底子见 Stable Diffusion 使用教程、ComfyUI 使用教程;工具路线见 AI 绘画工具怎么选。
先问:你缺的是风格,还是一张碰巧好看的图
如果只是「这张构图碰巧对了」,训 LoRA 是用大炮打蚊子。先把同一套提示词、种子、采样器跑稳,换 Checkpoint / 现成 LoRA 试三轮。三轮后仍系统性偏(脸型总漂、服装总错、品牌式细节总丢),再谈训练。
旁注:偶然成功属于抽卡;系统失败才属于资产问题。
如果…就…(带着旁注往下走)
如果你每周要固定角色出现在不同场景 → 值得评估 LoRA 或等价一致性方案。 旁注:一致性是功能,不是缘分。Midjourney 与本地路线的取舍,回到选型文,不在本文展开。
如果你只有十几张糊图、滤镜很重、角度单一 → 先别训。 旁注:垃圾进,风格化垃圾出。数据清洗比调 epoch 更决定上限。
如果你还不会最小文生图,节点全红或 WebUI 常 OOM → 先别训。 旁注:训练链路更长,排错面更大。先看 ComfyUI 常见报错排查 或 WebUI 报错排查。
如果你的目标是「学原理」而不是「交付」 → 可以训一个玩具级实验,但把预期写成学习,而不是生产。 旁注:学习型失败可接受;把学习型失败送进客户交付,不可接受。
如果你其实只是想追新模型热度 → 不建议。 旁注:新底模周周有,LoRA 与底模绑定,追新会制造孤儿权重。
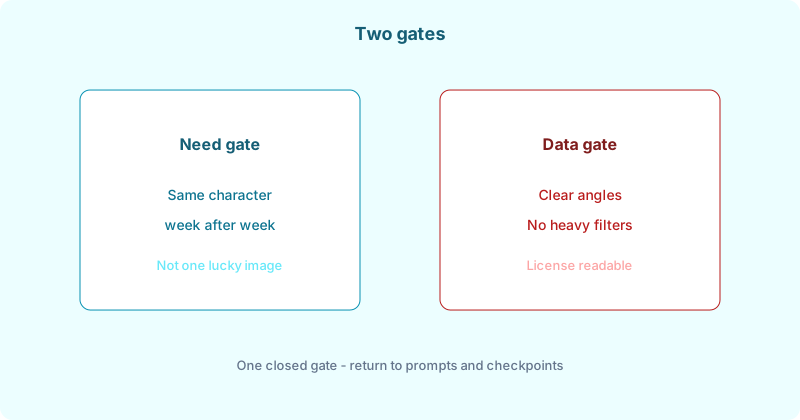
两扇门都开,才进入训练谈;一扇关着,先回去提示词与选模。
一条更便宜的替代阶梯
按成本从低到高,多数人应该停在更低的一阶:
- 提示词与负面词收紧;
- 换更合适的 Checkpoint;
- 用现成、许可清晰的 LoRA;
- 图生图 / 参考图工作流;
- 自己训。
直接跳到第 5 阶,常见动机是焦虑,不是需求。提示词侧的失败先按清单修,见 提示词失效排查。
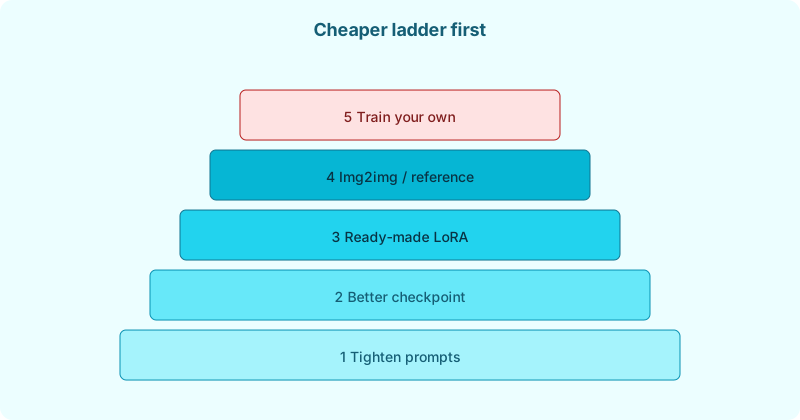
训模是阶梯顶端,不是入门仪式。
若你已经决定训:只签三条约束
不谈超参,只谈边界:
- 用途一句话:这个 LoRA 只解决哪个失败(脸 / 服装 / 画风)。多目标等于难收敛。
- 底模钉死:声明基于哪一版 Checkpoint;换底模就当新项目。
- 许可先读:训练素材与底模是否允许你的商用/分发场景;读不懂就先当不能商用。
做不到这三条,训练日志再漂亮也是负债。
什么时候该停训
- 验证集已经不涨,你还在加 epoch 赌运气;
- 过拟合到只有训练图角度能出;
- 你开始为了「救这个 LoRA」而改业务需求。
停比续更专业。废权重可以删;废掉的两周节假日删不掉。
本文是决策旁注,不是训练教程;界面与参数随版本变化,请以你使用的训练工具文档为准。