Appearance
ElevenLabs 使用教程:AI 配音、声音克隆与视频配音完整工作流
ElevenLabs 是目前语音自然度最高的 AI 配音平台之一:输入文字,选择声音,几秒内得到几乎听不出机器痕迹的语音。它不只是「文字转语音」工具——声音克隆(Voice Cloning)、多语言配音、视频自动配音(Dubbing)、AI 对话语音(Conversational AI)让它成为播客、有声书、视频本地化、教育内容的完整生产工具。
本文从注册开始,讲清楚 ElevenLabs 的核心功能,以及三个完整的端到端工作流:有声读物制作、YouTube 视频多语言配音、企业培训课程录制。
访问说明:ElevenLabs 服务器在境外(
elevenlabs.io),在中国大陆需要可访问境外网络的环境。
一、注册与套餐
- 打开
elevenlabs.io,选「Sign Up」,支持 Google 账号一键注册。 - 注册后进入 Free 计划,每月赠送 10,000 字符(约 10 分钟音频)。
套餐对比
| 套餐 | 月费(美元) | 字符/月 | 声音克隆 | 商业授权 | 并发请求 |
|---|---|---|---|---|---|
| Free | 0 | 10,000 | 无 | 非商业 | 1 |
| Starter | 5 | 30,000 | 1 个即时克隆 | 有 | 2 |
| Creator | 22 | 100,000 | 10 个即时+3个专业克隆 | 有 | 3 |
| Pro | 99 | 500,000 | 无限即时+无限专业克隆 | 有 | 5 |
10,000 字符约等于 10-12 分钟语音;100,000 字符约等于 100-120 分钟。如果主要用于日常测试和短片段,Starter 已足够;有声读物或大量视频配音选 Creator 以上。
二、Text to Speech:文字转语音
基本操作
- 左侧菜单选「Speech」→「Text to Speech」。
- 在右侧面板选择声音(Voice):平台内置超过 3000 个声音,按语言、性别、风格分类。
- 调节三个参数:
- Stability(稳定性):越高越一致,越低越有变化感,一般保持 50-70
- Clarity + Similarity(清晰度):越高越接近原声,一般保持 75 以上
- Style Exaggeration(风格强度):0 为中性,100 为最夸张,叙述性内容建议保持 0-20
- 粘贴文字,点「Generate」,试听后下载 MP3 或 WAV。
发音标注
遇到专有名词、外文、数字等容易读错的内容,用 SSML 标签控制发音:
<phoneme alphabet='ipa' ph='meɪ.dʒər'>major</phoneme>或者用括号注音法(更直观):
请联系我们的 CEO( CEO 读作 C-E-O)...
在文本里加括号说明,ElevenLabs 会识别并处理。
多说话人(多角色)
Creator 以上套餐支持在同一段文字里给不同段落指定不同声音,适合对话型内容(播客、有声剧):在文字前加 [Voice: 声音名称] 标签切换。
三、Voice Cloning:声音克隆
声音克隆分两种类型:
即时克隆(Instant Voice Cloning)
上传 30 秒以上干净音频(无背景噪音),约 30 秒内生成可用的克隆声音。
操作步骤:
- 左侧菜单「Voices」→「Add Voice」→「Instant Voice Cloning」。
- 上传录音文件(WAV/MP3,建议 44.1kHz,背景无噪音)。
- 填写声音名称,点「Add Voice」。
- 在 Text to Speech 里选择刚添加的声音即可使用。
适合场景:个人播客固定声音、公司品牌配音人声、给已有录音素材批量补录缺失段落。
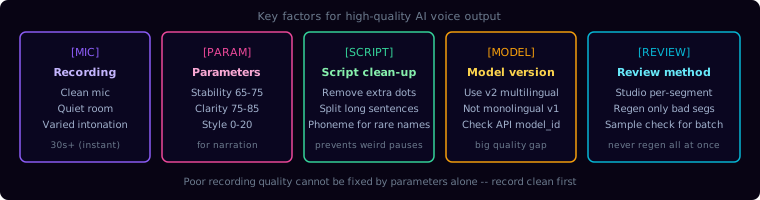
录音建议:
- 使用电容麦或带降噪功能的耳机麦
- 在安静房间录制,避免空调、键盘声
- 语速正常,不要特别慢也不要特别快
- 内容尽量覆盖不同语气(陈述句、疑问句、强调句)
专业克隆(Professional Voice Cloning)
需要上传超过 30 分钟的专业录音(Creator 套餐 3 个,Pro 无限),ElevenLabs 用更多数据做精细训练,自然度和细节还原大幅提升。
适合场景:有声书作者、公司发言人固定声音、品牌语音资产长期维护。
四、Dubbing:视频多语言配音
Dubbing 功能可以把一段视频的原声翻译并配成另一种语言,整个流程包括:语音识别 → 翻译 → TTS → 对口型时间对齐。
操作步骤:
- 左侧菜单「Dubbing」→「Create Dubbing」。
- 上传视频文件(或粘贴 YouTube/URL)。
- 选择原声语言和目标语言。
- 选择是否保留背景音(Music & Effects)——通常保留。
- 点「Dub」,等待处理(视频长度决定时间,约为视频时长的 2-5 倍)。
- 预览,下载带新配音的视频文件。
效果说明:
- 人声段落翻译后配音,每个说话人独立处理
- 时间轴对齐会尽量保持节奏,但目标语言比原语言长/短时会有微调
- 背景音乐和音效默认保留,不影响配音覆盖的人声段落
- 结果可在 Studio 模式里逐句编辑、替换单句配音
五、Studio:精细编辑工作台
Studio 是 ElevenLabs 的项目级工作台,适合处理长内容(有声书、课程):
- 把长文档拆成「段落」单元逐段生成,不像 TTS 页面一次性处理一大段
- 每个段落可以单独重新生成,不影响其他段落
- 内置时间轴视图,拖动调整每段的间隔停顿
- 支持多说话人切换(不同角色用不同声音)
进入 Studio:左侧菜单「Studio」→「New Project」→ 上传文本文件或直接粘贴。
六、三个端到端工作流
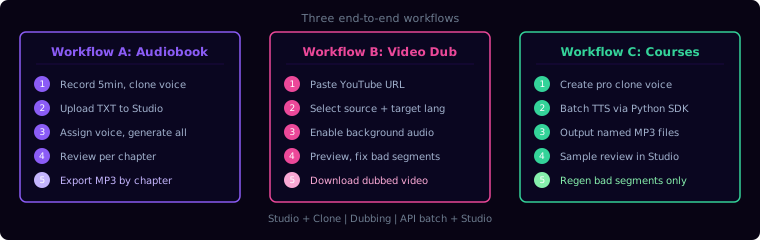
工作流 A:有声读物制作(约 5 万字,单人叙述)
工具:Studio + 即时声音克隆
- 录制 5 分钟样本音频,创建即时克隆声音(命名为「有声读物-主声」)
- Studio 新建项目,上传 TXT 格式稿件
- 全文指定「有声读物-主声」,生成所有段落
- 逐章试听,对读错的专有名词或停顿不自然的地方单段重新生成
- 最终导出完整 MP3(Studio 支持按章节分段导出)
参数建议:Stability 65,Clarity 80,Style 10(叙述性内容不需要夸张风格)。
工作流 B:YouTube 视频中文配音为英文
工具:Dubbing 功能
- Dubbing 页面粘贴 YouTube 链接
- 原声选「中文(普通话)」,目标选「英语(美国)」
- 开启「Keep background audio」
- 处理完成后,在 Studio 预览每个说话人片段,对明显不自然的句子手动替换
- 导出最终视频,可直接上传到 YouTube 英文频道
注意:视频中多人同时说话的片段,分离精度会下降,建议在原始剪辑时确保每个说话人有清晰分离的音轨。
工作流 C:企业培训课程批量录制
工具:API(批量生成)+ Studio(审核)
背景:企业有 20 门课、每门课约 8000 字脚本,需要批量生成语音,风格统一。
- 创建品牌专用声音(专业克隆,上传由专人录制的 30 分钟样本)
- 用 ElevenLabs Python SDK 写批处理脚本,循环读取 TXT 脚本文件,逐份调用 TTS API,输出命名为「课程名_章节号.mp3」
- 生成完成后用 Studio 抽样审核(每门课抽 2-3 段)
- 发现错误发音或停顿异常时,单段用 Studio 修改重新生成,替换对应 MP3
API 调用示例(Python):
from elevenlabs.client import ElevenLabs

client = ElevenLabs(api_key=YOUR_API_KEY)

audio = client.text_to_speech.convert(
    voice_id=YOUR_VOICE_ID,
    text=script_text,
    model_id='eleven_multilingual_v2',
    voice_settings={'stability': 0.65, 'similarity_boost': 0.80}
)
七、五类常见问题与修法
问题 1:克隆声音读长段落时中途「音色漂移」,听起来不像原声
原因:Stability 过低,模型每句都在微调。修法:把 Stability 调高到 70-80,用 Studio 分段生成替代一次性粘贴整篇。
问题 2:生成的音频里有奇怪的停顿或「呃……」类填充音
原因:脚本文本里有省略号、分号、冗余标点,模型把它们当成停顿提示。修法:在生成前清理脚本,把 …… 换成句号,; 换成 , 或单独断句。
问题 3:Dubbing 后发现某段说话人被误认
Dubbing Studio 支持手动调整说话人分配:进入「Speakers」视图,把被错误归类的片段拖到正确说话人的轨道。
问题 4:生成音频时报错「text too long」
免费版和低套餐有单次最大字符限制(约 5000 字符)。修法:用 Studio 分段处理,或升级套餐,或用 API 自行分块提交。
问题 5:API 调用生成的音频质量比网页端差
确认 model_id 用的是最新版(eleven_multilingual_v2 或更新),不要用旧版 eleven_monolingual_v1。参数设置保持和网页端一致。
FAQ
Q:克隆别人的声音是否合法?
ElevenLabs 要求用户只能克隆自己的声音或有明确授权的声音,并在平台上签署使用协议。未经授权克隆他人声音用于欺骗目的,在大多数法律体系下属于违规行为。平台有自动检测机制,会拒绝处理部分知名公众人物的录音。
Q:免费版的声音克隆功能够用吗?
免费版不包含克隆功能,需要 Starter 套餐(每月 5 美元)才能使用即时克隆。如果只是体验 TTS 效果,内置 3000+ 声音库在免费版完全可用。
Q:中文配音效果怎么样?
ElevenLabs 的中文 TTS 质量在近版本(2025-2026)有大幅提升,普通话发音清晰,语调自然。但对方言(粤语、闽南语)支持有限,且部分不常见的人名/地名仍可能发音异常,需要单独测试和调整。
Q:生成的音频版权归谁?
根据 ElevenLabs 政策,Starter 及以上套餐生成的音频,完整商业版权归用户所有,可用于商业发行(有声书、广告、课程等)。免费版仅限非商业用途。
Q:ElevenLabs 和 Azure TTS、Google TTS 的区别是什么?
Azure / Google TTS 是基础设施级别的服务,延迟低、价格便宜、API 成熟,适合构建需要高并发实时语音的产品(如语音助手、客服机器人)。ElevenLabs 的优势在于自然度和克隆精度,适合对音质要求高的内容制作;价格比前两者高,延迟也相对高。按用途选择:产品功能用 Azure/Google,内容制作用 ElevenLabs。