Appearance
LM Studio 使用教程:最简单的本地大模型运行工具
想在自己电脑上跑大模型,但一看到命令行就头疼?那 LM Studio 可能是你最需要的东西。
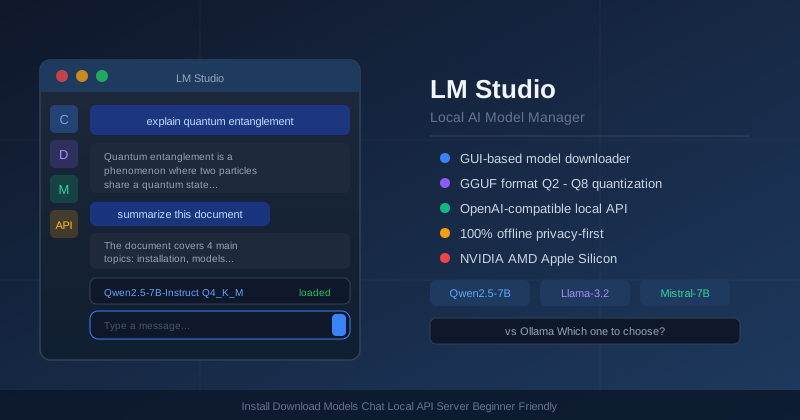
这个软件做的事情很纯粹:把“下载模型-运行模型-和它聊天”这三件事包装成一个有图形界面的桌面应用。你不需要懂 Python,不需要配环境变量,不需要记命令,打开软件、点几下鼠标、等模型下载完,就能开始对话了。
当然,它能做的不只是聊天。如果你是开发者,LM Studio 还有一个本地 API 服务器功能,可以把本地运行的模型暴露为 OpenAI 格式的接口,接进任何支持 OpenAI API 的工具或者自己的程序里。
本文从安装开始,把主要功能一步一步过一遍,包括和同类工具 Ollama 的比较,以及怎么根据自己的电脑配置选合适的模型。
为什么是 LM Studio,而不是 Ollama
不少人是先用 Ollama、后来才发现 LM Studio 的。这两个工具干的是同一件事——在本地运行开源大模型——但面向的人群不太一样。
Ollama 更适合技术用户。 它是纯命令行工具,用 ollama run qwen2.5:7b 这样的命令下载并运行模型,轻量、快,可以集成进脚本和自动化流程。但如果你不习惯终端,它的上手曲线会有点陡。
LM Studio 更适合普通用户。 它有完整的图形界面,下载模型可以在软件里搜索,运行参数可以用滑块调,对话历史有完整的会话管理。代价是占用磁盘和内存稍多一点,但换来的是真正的“开箱即用”。
如果你两个都装了——我确实这么做过——日常用 LM Studio 聊天测试,用 Ollama 处理脚本化需求,其实是蛮合理的搭配。但如果只选一个,新手选 LM Studio,不用多想。
系统要求
LM Studio 支持 Windows、macOS 和 Linux,官网在 lmstudio.ai。安装包不大,主程序本身也就几十 MB,真正占空间的是模型文件。
最低配置建议:
- 内存:至少 8GB,运行 7B 参数的模型推荐 16GB 以上
- 显存:有 NVIDIA GPU 且显存 6GB 以上可以使用 GPU 加速,速度会显著提升
- 磁盘:准备好 10~20GB 的空间,因为每个模型动辄 4~8GB
关于 Mac: 苹果 M 系列芯片(M1/M2/M3/M4)对本地模型运行的支持非常好。Apple Silicon 的统一内存架构让 LM Studio 在 Mac 上的表现出人意料地稳,一台 16GB 内存的 M2 MacBook Air 跑 7B 模型速度比很多有独立显卡的 Windows 笔记本还流畅。如果你有 Mac,本地模型这件事比在 Windows 上好很多。
关于 Windows 没有 GPU: 可以用 CPU 模式跑,但速度会很慢。7B 的模型用 CPU 生成文字大概每秒 5~10 个 token,和 GPU 的每秒 30~50 个 token 差距明显,用起来会有点等待感。如果只是偶尔测试,勉强够用;如果要日常使用,还是要有 GPU。
安装和初始设置
下载安装包直接安装,Windows 上是 .exe,Mac 是 .dmg,过程和普通软件一样没什么特别。
首次启动的界面
打开 LM Studio,左边是导航栏,主要分几块:
- Chat:对话界面
- Discover:搜索并下载模型
- My Models:管理已下载的模型
- Local Server:本地 API 服务器
- AI Playground:更多参数控制的测试环境
中间的欢迎页面会提示你先去 Discover 下载一个模型。这也是第一步要做的事。
设置下载路径
模型文件比较大,建议第一件事是去 Settings(左下角齿轮)把模型存储路径改到磁盘空间充足的地方,默认路径一般是 C 盘,如果你的 C 盘比较紧张,提前改到其他分区。
下载第一个模型
点左边的 Discover,你会看到一个搜索界面,可以直接搜模型名称,也可以按分类浏览。
GGUF 格式是什么
你会发现 LM Studio 里的模型名称后面都带着“GGUF”这几个字母。这是一种把大模型权重进行量化压缩之后的文件格式,适合在消费级硬件上运行。量化程度有不同级别,常见的有:
- Q4_K_M:4-bit 量化,质量和体积的较优平衡,是最常被推荐的版本
- Q5_K_M:5-bit 量化,比 Q4 质量好一点,文件略大
- Q8_0:8-bit 量化,最接近原始模型质量,但文件更大,需要更多内存
- Q2_K:2-bit 量化,文件最小,但质量损失明显,除非内存严重不足否则不推荐
新手选什么模型
不知道选什么的话,下面是一些靠谱的起点:
| 模型 | 参数量 | 内存需求 | 适合场景 |
|---|---|---|---|
| Qwen2.5-7B-Instruct Q4_K_M | 7B | ~6GB | 中文能力强,推理速度快,综合推荐 |
| Llama-3.2-3B-Instruct Q4_K_M | 3B | ~3GB | 内存较小的机器,轻量任务 |
| Mistral-7B-Instruct Q4_K_M | 7B | ~5GB | 英文能力优秀,逻辑推理不错 |
| Phi-3.5-mini-instruct Q4_K_M | 3.8B | ~3GB | 微软出品,小模型里表现出色 |
| Qwen2.5-14B-Instruct Q4_K_M | 14B | ~10GB | 更强推理,需要 16GB+ 内存 |
如果你主要用中文,优先选 Qwen2.5 系列,它是目前中文最强的开源模型系列之一,在中文理解和生成上比 Llama 系列好很多。
点模型旁边的下载按钮,然后等进度条走完,模型文件会自动保存到之前设置的路径里。下载速度取决于网络,有些模型文件有 4~8GB,耐心等一下。
开始对话
模型下载完成后,点左边的 Chat,在顶部的下拉菜单里选择你下载的模型,点 Load,等几秒钟模型加载进内存,就可以开始聊了。
对话界面
界面很直接,就是一个聊天窗口。输入框在下方,发送消息、AI 回复。右边有个设置面板,可以调整:
- Temperature:控制回复的随机性。接近 0 的时候回复更确定性、重复性高;接近 1 的时候更有创意但也更“飘”。日常对话用 0.7 左右就好。
- Max Tokens:单次最大生成长度,如果需要长回复,适当调大。
- System Prompt:在对话开始前给模型设定角色或者背景,比如“你是一个专业的 Python 程序员,请用简洁的方式回答编程问题”。
历史管理
LM Studio 的对话历史以会话形式管理,你可以给每个会话起名字,随时切换。这一点比 Ollama 要方便,Ollama 自带的聊天界面很简陋,历史记录管理很难用。
加载速度说明
第一次点 Load 加载模型的时候,需要把几 GB 的文件从磁盘读进内存,这个过程可能要 5~30 秒不等,取决于你的硬盘速度和内存大小。加载完之后,模型会一直驻留在内存里,之后的对话响应就很快了。如果你切换到别的模型,旧的模型会被卸载,内存释放。
本地 API 服务器:让其他程序用你的本地模型
这是 LM Studio 对开发者最有价值的功能。
点左边的 Local Server,然后点 Start Server,它会在本地开一个 HTTP 服务,默认端口是 1234。这个服务的接口和 OpenAI 的 API 格式完全兼容,也就是说任何支持自定义 OpenAI API 地址的工具,都可以指向 http://localhost:1234/v1 来用你本地跑的模型。
实际用法举例:
很多 AI 应用和工具都支持配置自定义 API 地址,比如 Open WebUI(一个开源的 ChatGPT 风格界面)、各种 VS Code 插件、还有你自己写的 Python 脚本。以 Python 为例:
from openai import OpenAI

client = OpenAI(
    base_url='http://localhost:1234/v1',
    api_key='lm-studio'  # 随便填,不验证
)

response = client.chat.completions.create(
    model='qwen2.5-7b-instruct',
    messages=[
        {'role': 'user', 'content': '用一句话解释什么是量子纠缠'}
    ]
)

print(response.choices[0].message.content)
代码几乎和调用 OpenAI API 一模一样,只是把 base_url 换成本地地址。这意味着你可以用本地模型测试和原型开发,等逻辑确认没问题再切换到真实的 OpenAI API。
Cursor 和其他 AI 编辑器也能用: 部分支持自定义 API 的 AI 编辑器可以指向 LM Studio 的本地服务器,在没有网络的环境下也能用 AI 辅助编程。不过本地 7B 模型的代码能力和 GPT-4 级别还是有差距,适合简单任务。
使用心得和注意事项
用了一段时间,有几个感受值得分享:
上下文窗口是个限制
本地运行的模型,上下文窗口一般比较小,默认可能只有 2048 或者 4096 个 token。如果你要处理长文档或者长对话,需要手动在设置里把 Context Length 调大,但代价是内存占用增加。8GB 内存的机器,7B 模型把 Context Length 拉到 8192,可能就比较紧张了。
中文标点有时候奇怪
部分模型在中文输出的时候会混用中英文标点,比如逗号、句号用英文半角形式输出。这是模型本身的训练问题,不同模型差异很大。Qwen 系列的中文标点通常比较正常,其他模型就不一定了。
不要期望和 GPT-4o 同等水平
本地 7B 的模型和 GPT-4o 差距是实实在在的,尤其在复杂推理、代码、多轮对话上。但对于日常的文字处理、简单问答、写作辅助,它已经够用,而且是完全本地、完全离线、完全免费的。
隐私是最大的优势
你发给本地模型的内容不会经过任何服务器,全程在自己电脑上处理。如果你有公司内部文档、个人隐私数据需要 AI 处理,本地模型是目前最安全的方案。
不要一次下太多模型
模型文件很大,很容易在磁盘上攒了一堆“用来试试”的模型,把硬盘塞满。建议保留 2~3 个常用的就好,用不到的及时删掉。在 My Models 里可以直接右键删除。
LM Studio 和 Ollama 详细对比
| 对比维度 | LM Studio | Ollama |
|---|---|---|
| 界面 | 完整图形界面,上手门槛低 | 纯命令行,需要终端操作 |
| 安装难度 | 简单,和普通软件一样 | 简单,但需要会用终端 |
| 模型管理 | 软件内搜索下载,图形化管理 | 命令行下载,模型库更新快 |
| 对话界面 | 功能完整,支持历史管理 | 基础终端对话,功能简单 |
| API 服务 | 内置 OpenAI 兼容服务器 | 内置 API 服务,也是 OpenAI 格式 |
| 资源占用 | 稍多(有 GUI) | 更轻量 |
| 自动化/脚本 | 不适合 | 非常适合,可以批量调用 |
| GPU 加速 | 支持 NVIDIA/AMD/Apple Silicon | 支持 NVIDIA/AMD/Apple Silicon |
| 适合人群 | 普通用户、初学者 | 开发者、有命令行习惯的用户 |
两个工具没有绝对好坏,看自己需求。
常见问题 FAQ
Q:LM Studio 是免费的吗? 个人使用完全免费,商业用途请查看官网许可协议。核心功能不需要付费。
Q:下载模型需要翻墙吗? LM Studio 的模型来自 Hugging Face,Hugging Face 在国内直接访问速度可能较慢或不稳定。有代理网络的话体验更好,也可以在软件设置里配置代理地址。
Q:我的电脑没有 GPU,能用吗? 可以,会用 CPU 运行,但速度比较慢。建议选 3B 参数以下的较小模型,或者量化程度较高(文件较小)的版本,以换取更快的速度。
Q:加载模型时报内存不足怎么办? 说明当前模型太大,超过了可用内存。解决方案:选更小的量化版本(比如从 Q4 换 Q2);或者换参数量更小的模型(比如从 7B 换 3B);或者关掉其他占内存多的程序。
Q:本地模型支持联网搜索吗? 默认不支持,本地模型是纯语言模型,没有检索工具。你需要额外配置工具调用或者 RAG 流程才能让它访问外部信息。这类高级功能超出了 LM Studio 基础使用范畴。
Q:和 Jan、AnythingLLM 这类工具比怎么样? Jan 的界面风格和 LM Studio 类似,也支持本地运行模型;AnythingLLM 更聚焦在知识库(RAG)应用场景上。如果只是想跑模型聊天,LM Studio 和 Jan 都很好,LM Studio 的模型兼容性稍宽一点。如果你要做文档问答,AnythingLLM 的整合体验更好。
Q:能不能用来处理图片? 可以,但需要选支持多模态的模型,比如 LLaVA 系列或者 Qwen2-VL 系列。在 Discover 里搜索时加“vision”或“VL”关键词可以找到。加载了多模态模型之后,聊天界面会出现图片上传按钮。
Q:多人可以同时连接本地 API 服务器吗? 技术上可以,但要注意本地服务器是单 GPU 资源,同时多个请求会排队,速度会下降。另外默认只绑定 localhost,要让其他设备访问需要改绑定地址,同时要确保网络安全。
推荐的使用场景
最后说几个 LM Studio 真正好用的场景:
文档处理和总结 把一篇英文报告或者长文档贴进对话框,让模型翻译或者提炼要点。离线处理,内容不出本地,适合有保密要求的材料。
写作初稿和改写 让模型帮你扩写大纲、改写段落风格、或者把一段流水账整理成有结构的文字。本地模型的中文表达有时候比较干,但作为初稿起点还是省时间。
代码学习辅助 对正在学编程的人,LM Studio 跑的本地模型可以解释代码含义、帮你改错、解答初级问题,而且不用担心把代码片段发到外部服务器。
API 开发测试 在开发接入 AI 的应用时,先用本地 LM Studio 服务器测试接口逻辑,调通之后再换成真实 API,可以节省 API 调用费用,也可以离线开发。
隐私数据处理 客户数据、个人财务、医疗信息之类,如果你需要 AI 帮你处理,本地模型是目前最合适的方案。
总结
LM Studio 在“本地模型工具”这个类别里,把易用性做到了目前最高水平。如果你有一台配置不太差的电脑,想体验一下在完全本地、完全免费的条件下跑大模型是什么感觉,它是最省事的入口。
下载安装,选一个 Qwen2.5-7B 的 Q4 量化版本,加载,聊几句——整个流程如果顺利的话,从零到第一次对话大概半小时以内(其中大半时间是在等模型下载)。这个体验门槛在所有本地模型方案里算是最低的了。
唯一的现实门槛:你需要有足够的内存和硬盘,还要有一点耐心面对“它没有 ChatGPT 那么聪明”这件事。但如果这两点你都接受,它能给你一个完全属于自己的 AI 对话环境,没有订阅费,没有数据外传,没有用量限制。